Gefühlt schneller, gemessen unklar: Was UX-Messung aus den METR-Studien lernen kann
Macht KI Entwickler produktiver? Die Studien von GitHub und METR zeigen vor allem, wie leicht Messdesigns kippen. Was UX-Teams daraus lernen.
Ob KI Softwareentwicklung schneller macht, lässt sich mit den bisherigen Studien nicht sicher sagen, und das liegt weniger an der Technik als am Messdesign. Im Copilot-Experiment von 2023 war die KI-Gruppe 55,8 % schneller, in der METR-Studie von 2025 brauchten erfahrene Entwickler mit KI 19 % mehr Zeit, hielten sich aber für 20 % schneller. 2026 erklärte METR das eigene Design für nicht mehr valide. Die Fehlerquellen dahinter, Selektion, Aufgabenwahl, Ergebnisqualität und Selbstauskunft, kennt die UX-Forschung seit Jahren.
Das Doppelparadox
Zwei Studien, zweimal lagen die Teilnehmenden mit ihrer Einschätzung daneben, allerdings in entgegengesetzter Richtung.
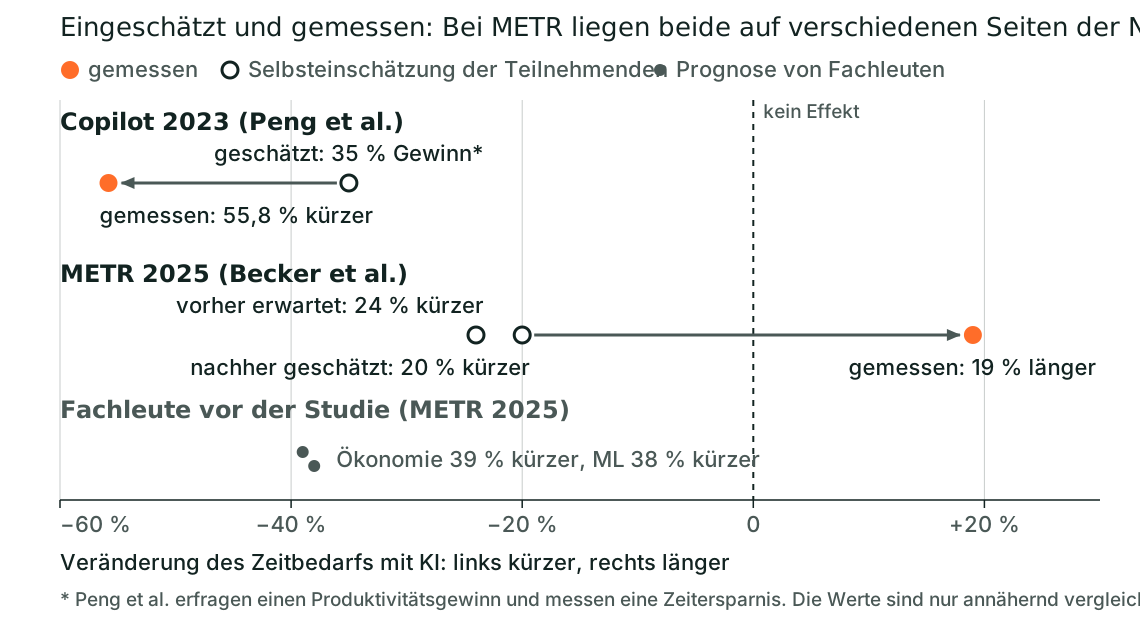
2023 veröffentlichten Peng und Kolleg:innen ein Experiment mit GitHub Copilot. Die Gruppe mit KI-Unterstützung war 55,8 % schneller fertig, schätzte ihren Gewinn im Mittel aber nur auf 35 %. Die Leute haben also unterschätzt, was das Werkzeug für sie getan hat.
2025 veröffentlichte die Forschungsorganisation METR eine Studie mit erfahrenen Open-Source-Entwicklern. Mit KI brauchten sie 19 % mehr Zeit. Nach der Studie schätzten sie trotzdem, die KI habe sie um 20 % beschleunigt. Hier lag die Einschätzung nicht nur in der Höhe daneben, sondern im Vorzeichen.
Ich lese beide Studien nicht als KI-Entwickler, sondern als jemand, der seit vielen Jahren Fragebögen und Evaluationsdesigns für User Experience baut. Aus dieser Sicht ist das Spannende nicht die Frage, ob KI schneller macht. Spannend ist, wie schwer es ist, das überhaupt sauber zu messen, und wie vertraut mir die Probleme vorkommen, an denen die Studien gescheitert sind oder die sie offen benennen.
Deshalb die Frage an dich, bevor wir einsteigen: Woher weißt du, dass ein KI-Tool deinem Team hilft? Weil es sich so anfühlt? Weil alle es weiter nutzen? Oder weil du es gemessen hast? Dass die Antwort nicht nur vom Werkzeug abhängt, sondern auch davon, wie ein Team arbeitet, habe ich unter KI-gestützte Entwicklung ausgeführt. Hier geht es um die Frage davor: wie man den Effekt überhaupt misst.
Was die Studien gemessen haben
Beide Studien sind RCTs, also randomisierte kontrollierte Experimente: Der Zufall entscheidet, wer oder was mit KI arbeitet, damit sich die Bedingungen nur in diesem einen Punkt unterscheiden. Trotzdem messen sie Verschiedenes, weil fast jede andere Designentscheidung anders ausfällt.
Copilot 2023. Peng, Kalliamvakou, Cihon und Demirer rekrutierten im Mai und Juni 2022 über die Freelancer-Plattform Upwork 95 Programmierer:innen und teilten sie zufällig auf: 45 mit Copilot, 50 ohne. Alle bekamen dieselbe Aufgabe, einen HTTP-Server in JavaScript zu schreiben. Zwölf Tests waren im Repository sichtbar; gemessen wurde die Zeit bis zum ersten Commit, der alle zwölf besteht. Die Vergütung hing von der Bearbeitungszeit ab, schnelles Arbeiten wurde also belohnt.
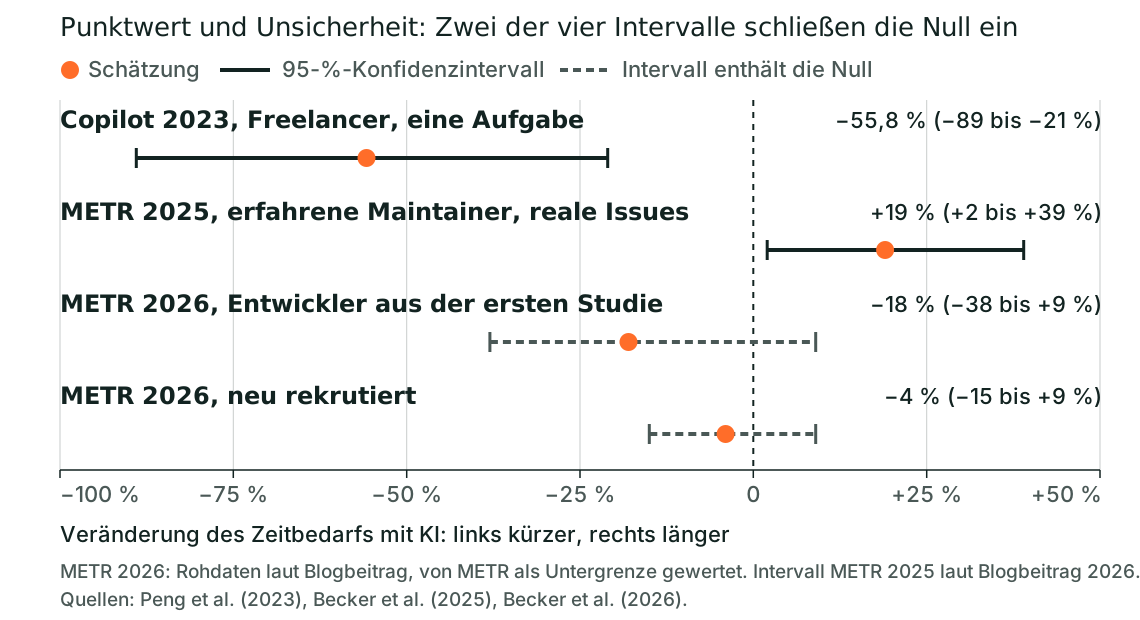
Das Ergebnis laut Paper: im Mittel 71,17 Minuten mit Copilot gegenüber 160,89 Minuten ohne, eine um 55,8 % kürzere Bearbeitungszeit. Das 95-%-Konfidenzintervall, also der Bereich, in dem der wahre Effekt mit hoher Sicherheit liegt, reicht von 21 % bis 89 %. Der Effekt ist damit deutlich, seine Größe aber ziemlich unsicher. Weniger erfahrene Entwickler:innen profitierten laut den Autoren stärker. Und die Autoren benennen die Grenzen selbst: Es war eine standardisierte Aufgabe, und über Codequalität sagt die Studie nichts. Die Standardisierung war bewusst gewählt, „Using a standardized task provides us with precise measures of performance“ (eine standardisierte Aufgabe liefert präzise Leistungsmaße). Präzise ja, aber präzise für genau diese eine Aufgabe.
METR 2025. Becker, Rush, Barnes und Rein gingen den umgekehrten Weg. Zwischen Februar und Juni 2025 bearbeiteten 16 erfahrene Open-Source-Entwickler 246 echte Issues aus Repositories, an denen sie selbst mitarbeiten. Diese Projekte haben laut Paper im Schnitt 23.000 Sterne auf GitHub und über 1,1 Millionen Codezeilen, die Teilnehmenden kannten ihr Repository im Schnitt seit fünf Jahren. Ein Issue dauerte im Schnitt etwa zwei Stunden, bezahlt wurde mit 150 US-Dollar pro Stunde, unabhängig vom Tempo. Die Entwickler legten ihre Issues vorab fest, erst danach wurde jedes einzelne zufällig der Bedingung „KI erlaubt“ oder „KI nicht erlaubt“ zugewiesen. Als Werkzeug diente meist Cursor Pro mit Claude 3.5 oder 3.7 Sonnet.
Das Ergebnis: Mit KI brauchten die Entwickler 19 % mehr Zeit. Das Konfidenzintervall gibt METR in einem Blogbeitrag von 2026 mit plus 2 % bis plus 39 % an; die Verlangsamung ist also knapp von null unterscheidbar, ihre Größe offen. Laut Paper waren 75 % der Entwickler mit KI langsamer, es war also kein Effekt einzelner Ausreißer. Fachleute hatten das Gegenteil erwartet: 34 befragte Ökonom:innen im Mittel 39 % Zeitersparnis, 54 ML-Fachleute 38 %.
METR warnt ausdrücklich davor, daraus zu schließen, KI mache Entwickler generell langsamer; eine eigene Tabelle im Paper listet, was die Studie nicht zeigt. Wenn du die beiden Designs nebeneinanderlegst, siehst du den Grund: synthetische Aufgabe gegen reale Issues, Freelancer gegen langjährige Maintainer, Bezahlung nach Tempo gegen Bezahlung pro Stunde. Jede dieser Entscheidungen verändert, was „Produktivität“ in der jeweiligen Studie überhaupt bedeutet.
Die Tabelle stellt die Designs nebeneinander, einschließlich der Folgestudie von 2026, um die es im nächsten Abschnitt geht.
| Copilot (Peng et al. 2023) | METR 2025 | METR 2026 (Blogbeitrag) | |
|---|---|---|---|
| Teilnehmende | 95 Freelancer (Upwork) | 16 erfahrene Open-Source-Maintainer | 57 Entwickler (10 aus 2025, 47 neu) |
| Aufgaben | 1 standardisierte Aufgabe (HTTP-Server) | 246 reale Issues aus eigenen Repositories | über 800 Aufgaben, 143 Repositories |
| Zufallszuweisung | pro Person | pro Issue, Issues vorab festgelegt | pro Aufgabe, Aufgaben vorab festgelegt |
| Vergütung | nach Bearbeitungszeit | 150 USD pro Stunde | 50 USD pro Stunde |
| Zeitbedarf mit KI | 55,8 % kürzer (Intervall 21 % bis 89 %) | 19 % länger (Intervall +2 % bis +39 %) | 18 % bzw. 4 % kürzer, beide Intervalle schließen null ein |
| Selbsteinschätzung | 35 % Gewinn geschätzt | 20 % Beschleunigung geschätzt | nicht berichtet |
| Grenze laut Autoren | keine Aussage zur Codequalität | keine Verallgemeinerung (Tabelle 2 im Paper) | Design nicht mehr valide, Werte als Untergrenze |
Intervall = 95-%-Konfidenzintervall. Quellen: Peng et al. (2023), Becker et al. (2025), Becker et al. (2026).
Warum das Messdesign zerbricht
Schon 2025 nannte METR einen Faktor, der sich im Nachhinein als der entscheidende herausstellte. Im Paper steht als offene Frage, Entwickler, die stark auf KI setzen, könnten seltener teilnehmen, weil sie ungern bei der Hälfte ihrer Aufgaben auf KI verzichten. In einer Fußnote berichten die Autoren von einer teilnehmenden Person, die nach Studienende sagte, sie werde wohl nicht wieder mitmachen, genau aus diesem Grund. Damals eine Randnotiz.
Im August 2025 startete METR eine Folgestudie: 57 Entwickler, davon 10 aus der ersten Studie und 47 neue, 143 Repositories, über 800 Aufgaben, bezahlt mit 50 US-Dollar pro Stunde. Am 24. Februar 2026 veröffentlichte das Team dazu kein Paper, sondern einen Blogbeitrag, und der ist im Kern eine Absage an das eigene Design. Die Rohdaten zeigen für die zehn Entwickler aus der ersten Studie einen um 18 % geringeren Zeitbedarf mit KI (Intervall minus 38 % bis plus 9 %), für die neu Rekrutierten minus 4 % (Intervall minus 15 % bis plus 9 %). Beide Intervalle schließen null ein, die Daten können also auch „kein Effekt“ bedeuten. METR hält die Werte für eine Untergrenze und das Ganze für „likely a bad proxy for the real productivity impact of AI tools“ (wahrscheinlich ein schlechter Stellvertreter für den echten Produktivitätseffekt von KI-Tools).
Die Gründe, die METR nennt, lese ich als klassische Messprobleme, wie sie in jeder UX-Messung auftauchen. Fast jedes hat eine Parallele in der UX-Forschung.
Stichprobenselektion. Laut Blogbeitrag lehnen zunehmend Entwickler die Teilnahme ab, weil sie nicht ohne KI arbeiten wollen; die niedrigere Vergütung hat die Selektion vermutlich verstärkt. Damit fehlen genau die Personen, die am meisten von KI erwarten. Selection Bias, also eine Verzerrung durch die Auswahl der Teilnehmenden, kennst du aus jeder Nutzerbefragung: Wer antwortet, ist nicht zufällig, sondern oft besonders zufrieden, besonders verärgert oder hat schlicht Zeit. Wer nicht mitmacht, fehlt in den Daten, aber nicht in der Wirklichkeit.
Aufgabenwahl. 30 % bis 50 % der Entwickler gaben laut METR an, bestimmte Aufgaben gar nicht erst einzureichen, weil sie diese nicht ohne KI erledigen wollten. Außerdem verschoben sich die Aufgabentypen in Richtung dessen, was KI gut kann. Das ist, als dürften Teilnehmende im Usability-Test die Aufgaben selbst auswählen: Du misst dann ihre Vorlieben, nicht das Produkt. In der UX-Forschung legen wir Aufgaben deshalb vor dem Test fest und wählen sie nach der Nutzungsrealität, nicht nach der Bequemlichkeit.
Effizienz gegen Ergebnisqualität. Einige Entwickler berichteten, dass sich das Ergebnis je nach Bedingung unterschied, etwa bei Codequalität, Tests oder Dokumentation. Eine Zeitdifferenz ist dann keine Produktivitätsdifferenz mehr, weil unterschiedliche Dinge fertig wurden. Im Usability-Test würde niemand die Bearbeitungszeit zweier Gruppen vergleichen, ohne zu prüfen, ob beide die Aufgabe tatsächlich gelöst haben.
Abbrüche als Datum. Aufgaben ohne KI wurden laut METR seltener abgeschlossen, ein Entwickler schloss keine einzige davon ab. Wer nur fertige Aufgaben auswertet, wirft genau diese Information weg. In der UX-Forschung ist ein Abbruch ein Ergebnis, kein fehlender Wert.
Zeiterfassung. Wer mehrere KI-Agenten parallel laufen lässt und in der Wartezeit etwas anderes erledigt, kann kaum sagen, wie lange eine Aufgabe gedauert hat. Time-on-Task, also die gemessene Bearbeitungszeit, setzt voraus, dass jemand an einer Sache arbeitet. Das gilt für Entwicklungsarbeit mit Agenten immer seltener.
METR plant nun andere Wege: kürzere und intensivere Experimente, Beobachtungsdaten, sorgfältig gestaltete Fragebögen zusammen mit Zeitnutzungsstudien, Experimente mit festen Aufgaben, Evals der Agenten und Randomisierung auf Personenebene statt pro Aufgabe. Das ist kein Scheitern, sondern Methodenarbeit, wie wir sie aus der UX-Evaluation kennen: Das Design folgt der Frage, und wenn sich das Feld ändert, muss sich das Design mitändern.
Erleben ist nicht Leistung
Ein Befund der METR-Studie von 2025 geht in der Debatte oft unter: Die Selbstauskunft der Entwickler war nicht grundsätzlich unzuverlässig. Auf derselben Teilmenge von Issues ergab die Auswertung über Bildschirmaufzeichnungen 25 % Verlangsamung, die über selbst berichtete Zeiten 24 %; die Selbstauskunft über die Dauer war also brauchbar. Auch die Prognosen, wie lange ein Issue dauern würde, hingen mit den tatsächlichen Zeiten zusammen, mit Korrelationen von 0,64 (mit KI) und 0,59 (ohne KI), was für Schätzungen dieser Art ein ordentlicher Zusammenhang ist.
Falsch lag nur eine Einschätzung: ob KI hilft. Vorher erwarteten die Entwickler 24 % Beschleunigung, nachher schätzten sie 20 %, gemessen waren 19 % Verlangsamung. Der Unterschied zwischen den beiden Fragen ist entscheidend. „Wie lange hast du gebraucht?“ fragt nach etwas Beobachtbarem. „Wie viel schneller warst du mit KI?“ fragt nach einem kontrafaktischen Effekt, also nach dem Vergleich mit einer Situation, die nicht stattgefunden hat. Dafür hat niemand eine Wahrnehmung. Die Copilot-Studie zeigt das von der anderen Seite: Die Kontrollgruppe gab ihre Schätzung ab, nachdem sie ein einminütiges Demo-Video gesehen hatte, ohne das Tool selbst benutzt zu haben, und landete im Mittel beim selben Wert von 35 % wie die Gruppe, die damit gearbeitet hatte.
Warum aber lagen die Entwickler 2025 so deutlich daneben? METR diskutiert eine Erklärung, die ich für UX-Leute besonders interessant finde: Leichtigkeit statt Tempo. Einzelne Entwickler berichteten, das Arbeiten mit KI habe sich nach weniger Aufwand angefühlt, einer sagte, es „felt like less effort“ (fühlte sich nach weniger Aufwand an). Andere berichteten keinen Unterschied. 69 % nutzten Cursor nach Studienende weiter, was laut METR dafür spricht, dass sie einen Wert darin sehen. METR selbst bewertet diesen Faktor als unklar, und das ist ehrlich.
Jetzt folgt meine Interpretation, kein Studienergebnis. Im UEQ unterscheiden wir pragmatische Qualität, also wie effizient, durchschaubar und verlässlich ein Produkt erlebt wird, von hedonischer Qualität, also wie anregend und neuartig es sich anfühlt (Laugwitz, Held & Schrepp, 2008). Beides ist erlebte Qualität, nicht gemessene Leistung. Ein Werkzeug kann als effizient erlebt werden, weil es die mühsamen Teile der Arbeit abnimmt, etwa das Tippen von Boilerplate-Code oder das Nachschlagen einer API. Die Zeit fließt dann in Prompten, Warten und Prüfen. Genau das zeigen die Aufzeichnungen von METR: mit KI weniger aktives Programmieren und Recherchieren, dafür Prompten, Warten auf die KI, Prüfen ihrer Ausgaben und etwas mehr Leerlauf. Etwa 9 % der Zeit gingen in das Prüfen und Bereinigen von KI-Code, etwa 4 % ins Warten. Weniger als 44 % der Vorschläge wurden angenommen, 75 % der Entwickler gaben an, jede Zeile KI-Code zu lesen.
Diese Tätigkeiten fühlen sich womöglich leichter an als konzentriertes Programmieren, auch wenn sie in Summe länger dauern. Dazu kommt eine hedonische Komponente: Ein neues Werkzeug kann anregend sein, und das erhöht die Bereitschaft, es weiter zu nutzen. Hohe Weiternutzung und das Gefühl, schneller zu sein, sind dann keine Belege für Effizienz, sondern Hinweise auf erlebte Qualität. Beides ist legitim. Nur solltest du es nicht verwechseln. Wie sich die Arbeit mit Coding-Agenten in eigenen Projekten anfühlt, habe ich in Mal eben gebaut beschrieben.
Was du morgen tun kannst
Du brauchst kein Forschungsinstitut, um im eigenen Team belastbarer zu bewerten, ob ein KI-Tool hilft. Du brauchst ein paar Regeln, die direkt aus den Schwächen der Studien folgen. Das ergibt kein RCT, aber ein Design, das die bekannten Fallen umgeht.
-
Aufgaben vor der Zuweisung festlegen. Sammle die Aufgaben der nächsten Wochen, bevor entschieden wird, welche mit und welche ohne KI bearbeitet werden. Entscheide dann zufällig, etwa per Liste oder Münzwurf. So verhinderst du, dass sich die Leute die KI-tauglichen Aufgaben aussuchen, wie es METR 2026 beobachtet hat.
-
Zeit und Ergebnisqualität getrennt erheben. Erfasse neben der Dauer, was am Ende herauskommt: Review-Befunde, Nacharbeit, Tests, Dokumentation. Im UX-Kontext wären das Fehler, Konsistenz oder Vollständigkeit eines Entwurfs. Eine schnellere Aufgabe mit mehr Nacharbeit ist keine schnellere Aufgabe.
-
Beobachtbare Größen erfragen, nicht geschätzte Effekte. Frag „Wie lange hat die Aufgabe gedauert?“ und nicht „Wie viel Zeit hat dir die KI gespart?“. Die erste Frage beantworten Menschen laut METR 2025 recht verlässlich, die zweite nicht. Wenn parallel Agenten laufen, erfasse zusätzlich, woran jemand in der Wartezeit gearbeitet hat.
-
Erlebte Qualität separat messen. Frag gezielt nach dem Erleben, etwa mit dem UEQ oder UEQ+ nach einer Arbeitsphase mit und ohne KI. Wie du den UEQ dafür einsetzt und auswertest, ist Thema von Mastering UEQ. Werte das getrennt von der Leistung aus. Wenn ein Tool sich besser anfühlt, ohne schneller zu machen, ist das eine eigene, wertvolle Information, etwa für Zufriedenheit und Belastung im Team.
-
Abbrüche und Nicht-Teilnahme dokumentieren. Notiere, welche Aufgaben nicht abgeschlossen, zurückgezogen oder gar nicht erst eingebracht wurden, und wer nicht mitmachen wollte, jeweils mit Grund. Das sind keine Lücken in den Daten, sondern Daten. Genau an dieser Stelle ist das Design von METR 2026 gekippt.
-
Unsicherheit mitberichten. Bei einem kleinen Team wirst du keine präzise Prozentzahl bekommen. Selbst METR kam mit 16 Personen und 246 Issues auf ein Intervall von plus 2 % bis plus 39 %. Berichte deshalb Spannweiten und Tendenzen statt eines einzelnen Werts, und sag dazu, für welche Aufgaben und welche Personen deine Aussage gilt.
Keiner dieser Punkte ist neu. Jeder davon gehört zum Handwerkszeug einer guten Usability-Evaluation. Neu ist nur, dass wir sie jetzt auf Werkzeuge anwenden müssen, die wir selbst benutzen.
Schluss
Die Debatte über KI und Produktivität wird oft als Streit über die Technik geführt: Werden die Modelle gut genug, sind die Tools ausgereift, nutzen die Leute sie richtig? Die drei Studien, die ich hier betrachtet habe, zeigen etwas anderes. Die Antwort hängt mindestens ebenso stark davon ab, welche Aufgaben man misst, wen man fragt, wer mitmacht, was als fertig gilt und ob man nach Beobachtbarem oder nach Vermutetem fragt.
METR hat das mit bemerkenswerter Offenheit dokumentiert, bis hin zur Aussage, das eigene Design liefere keine verlässlichen Werte mehr. Für mich ist das die wichtigste Lehre aus den Studien: Wer ein Messdesign ernst nimmt, muss auch benennen, wann es nicht mehr trägt.
Für Produktteams heißt das: Wenn du KI-Werkzeuge bewertest, brauchst du dieselbe Messdisziplin wie bei jeder UX-Evaluation. Aufgaben vorher festlegen, Leistung und Erleben getrennt messen, Abbrüche ernst nehmen, Unsicherheit offen berichten. Das Gefühl, schneller zu sein, ist ein echtes Datum über das Erleben. Ein Beleg für Produktivität ist es nicht.
Quellen
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (arXiv:2507.09089v2). arXiv. https://arxiv.org/abs/2507.09089 (abgerufen am 24.09.2026)
Becker, J., Rush, N., Cunningham, T., Rein, D., & Mahamud, K. (2026, 24. Februar). We are Changing our Developer Productivity Experiment Design [Blogbeitrag]. METR Blog. https://metr.org/blog/2026-02-24-uplift-update/ (abgerufen am 24.09.2026). Hinweis: Blogbeitrag ohne Peer Review; bislang die einzige Veröffentlichung zu dieser Studie.
Laugwitz, B., Held, T., & Schrepp, M. (2008). Construction and evaluation of a user experience questionnaire. In A. Holzinger (Hrsg.), HCI and Usability for Education and Work (LNCS Bd. 5298, S. 63 bis 76). Springer. https://doi.org/10.1007/978-3-540-89350-9_6
Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The Impact of AI on Developer Productivity: Evidence from GitHub Copilot (arXiv:2302.06590v1). arXiv. https://arxiv.org/abs/2302.06590 (abgerufen am 24.09.2026)
Häufige Fragen
Die Studienlage ist widersprüchlich, und das liegt vor allem am Messdesign. Im Copilot-Experiment von Peng et al. (2023) war die Gruppe mit KI bei einer standardisierten Aufgabe 55,8 % schneller. In der METR-Studie von 2025 brauchten erfahrene Open-Source-Entwickler bei echten Issues aus ihren eigenen Repositories mit KI 19 % mehr Zeit. Die Folgestudie von METR zeigt in den Rohdaten Hinweise auf eine Beschleunigung, METR hält das eigene Design aber nicht mehr für verlässlich. Welche Aufgaben gemessen werden, wer teilnimmt und wie bezahlt wird, prägt das Ergebnis mindestens so stark wie das Werkzeug.
Wegen Selektionseffekten. Laut METR-Blogbeitrag vom 24. Februar 2026 lehnen zunehmend Entwickler die Teilnahme ab, weil sie nicht ohne KI arbeiten wollen. 30 % bis 50 % der Teilnehmenden reichten bestimmte Aufgaben gar nicht erst ein, um sie nicht ohne KI bearbeiten zu müssen. Dazu kommen verschobene Aufgabentypen, unterschiedliche Ergebnisqualität je Bedingung, seltener abgeschlossene Aufgaben ohne KI und unzuverlässige Zeiterfassung, wenn mehrere KI-Agenten parallel laufen. METR wertet die gemessenen Werte deshalb als Untergrenze.
Teilweise. In der METR-Studie von 2025 waren selbst berichtete Bearbeitungszeiten verlässlich: Die Auswertung über Bildschirmaufzeichnungen ergab 25 % Verlangsamung, die über Selbstauskunft 24 %. Falsch lag die Einschätzung, ob KI hilft: Die Entwickler hielten sich für 20 % schneller, waren aber 19 % langsamer. Fragen nach Beobachtbarem, etwa nach der Dauer einer Aufgabe, funktionieren. Fragen nach einem kontrafaktischen Effekt, also nach dem Vergleich mit einer Situation, die nicht stattgefunden hat, funktionieren nicht.
Mit derselben Messdisziplin wie bei einer UX-Evaluation. Lege Aufgaben fest, bevor entschieden wird, welche mit KI bearbeitet werden, und entscheide dann zufällig. Erhebe Zeit und Ergebnisqualität getrennt. Frag nach der tatsächlichen Dauer statt nach geschätzter Zeitersparnis. Miss das Erleben separat, etwa mit dem UEQ. Dokumentiere Abbrüche, nicht eingereichte Aufgaben und Nicht-Teilnahme. Und berichte Spannweiten statt eines einzelnen Werts.
METR nennt als mögliche Erklärung, dass Entwickler Tempo gegen Leichtigkeit tauschen: Einzelne berichteten, die Arbeit mit KI habe sich nach weniger Aufwand angefühlt, und 69 % nutzten Cursor nach der Studie weiter. METR selbst wertet diesen Faktor als unklar. Aus Sicht der UX-Messung ist das plausibel: Ein Werkzeug kann als effizient und anregend erlebt werden, weil es mühsame Teile der Arbeit abnimmt, während die Zeit in Prompten, Warten und Prüfen fließt. Erlebte Qualität und gemessene Leistung sind zwei verschiedene Größen.