Ein guter Assistent ist einer, der weiß, wann er abgibt
Conversational Design ist nicht die Kunst, einen guten Chatbot zu bauen. Es ist die Fähigkeit, begründet zu entscheiden, wo Konversation hingehört und wo nicht. Was sich mit LLMs verschoben hat und was geblieben ist.
Conversational Design ist nicht die Kunst, einen guten Chatbot zu bauen. Die Kernkompetenz ist die begründete Modalitätsentscheidung: Wo in einer Customer Journey gehört ein Gespräch hin, wo ein Formular, wo ein Mensch, und wie werden die Übergänge gestaltet? Ich habe dazu gerade ein zweitägiges Seminar für UX-Professionals gebaut, acht Blöcke, ein durchgehender Übungsfall. Was dabei herausgekommen ist, ist weniger eine Chatbot-Schulung als eine Standortbestimmung: Was von der Disziplin bleibt, wenn die Sprachmodelle den technischen Teil übernehmen, und was dadurch erst wichtig wird.
Zwei Lesarten, die ständig vermischt werden
Der Begriff hat zwei Bedeutungen, und fast jede zähe Diskussion zum Thema lässt sich darauf zurückführen, dass zwei Leute unterschiedliche meinen.
Conversational Design als Medium ist die Gestaltung für Chat- und Voice-Kanäle. Messenger, Website-Chat, Sprachassistent, Telefonbot. Die Frage lautet: Wie gestalten wir gut für diesen Kanal?
Conversational Design als Designphilosophie nimmt die Prinzipien menschlicher Konversation als Interaktionsmodell: Turn-Taking, geteilter Kontext, Reparatur. Die Frage lautet: Was können wir von Gesprächen für jede Schnittstelle lernen?
Beide Lesarten sind legitim. Wer sie vermischt, diskutiert aneinander vorbei. Und die zweite ist der Grund, warum das Thema angewandtes UX ist und keine Silodisziplin.
Was ein Gespräch ausmacht, und warum das Theorie von 1974 ist
Eine Konversationsschnittstelle zu gestalten heißt, eine Interaktion zu gestalten, die drei Eigenschaften hat. Sie ist turnbasiert: Beiträge wechseln sich ab. Sie ist kontexttragend: Gesagtes bleibt gültig. Sie ist reparaturfähig: Missverständnisse werden im Gespräch behoben. An diesen drei Eigenschaften wird jedes System gemessen, egal ob regelbasiert oder LLM-basiert.
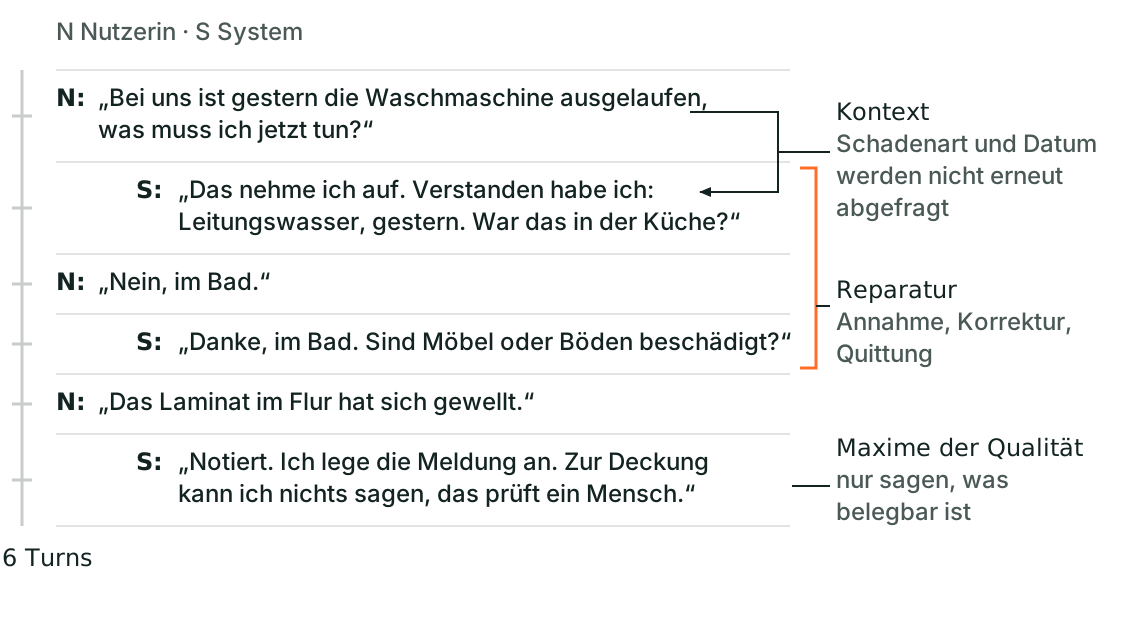
Das ist keine Erfindung der Chatbot-Ära. Sacks, Schegloff und Jefferson haben 1974 die Systematik des Sprecherwechsels beschrieben, und zwei Dinge daraus tragen die ganze Disziplin. Erstens Adjazenzpaare: Eine Frage erwartet eine Antwort, ein Angebot erwartet Annahme oder Ablehnung. Wer nach seiner Frage eine Gegenfrage zur Vertragsnummer bekommt, erlebt eine verletzte Erwartung, die er als Mensch mitbringt. Zweitens Reparatur als Normalfall: Selbstkorrektur, Nachfrage, Neuformulierung. Menschen reparieren beiläufig. Systeme müssen es explizit gestaltet bekommen.
Dazu kommt Clark: Common Ground ist das, was beide Seiten als geteilt voraussetzen, und Grounding ist der Prozess, der das herstellt. Bestätigen, nachfragen, zusammenfassen. Verstehen ist nicht der Normalzustand, sondern das Ergebnis von Arbeit. Übersetzt für die Praxis: Bestätigungen und Korrekturen sind keine Höflichkeit, sie sind die Mechanik, die ein Gespräch trägt.
Und Grice liefert das Prüfraster für jede einzelne Systemantwort. Vier Maximen, an denen sich messen lässt, ob ein Beitrag kooperativ ist:
| Maxime | Erwartung | Typischer Verstoß im Dialogsystem |
|---|---|---|
| Quantität | So informativ wie nötig, nicht mehr | Ein Textblock als Antwort auf eine Ja-Nein-Frage |
| Qualität | Nur sagen, was man für wahr hält und belegen kann | Die Halluzination |
| Relation | Relevant zum aktuellen Gesprächsstand | Die Rückfrage, die den Faden verliert |
| Modalität | Klar, geordnet, ohne Mehrdeutigkeit | Verschachtelte Doppelfragen |
Die Qualitätsmaxime ist die, die ein Sprachmodell strukturell gefährdet. Dazu weiter unten mehr.
Die strukturelle Schwäche heißt Discoverability
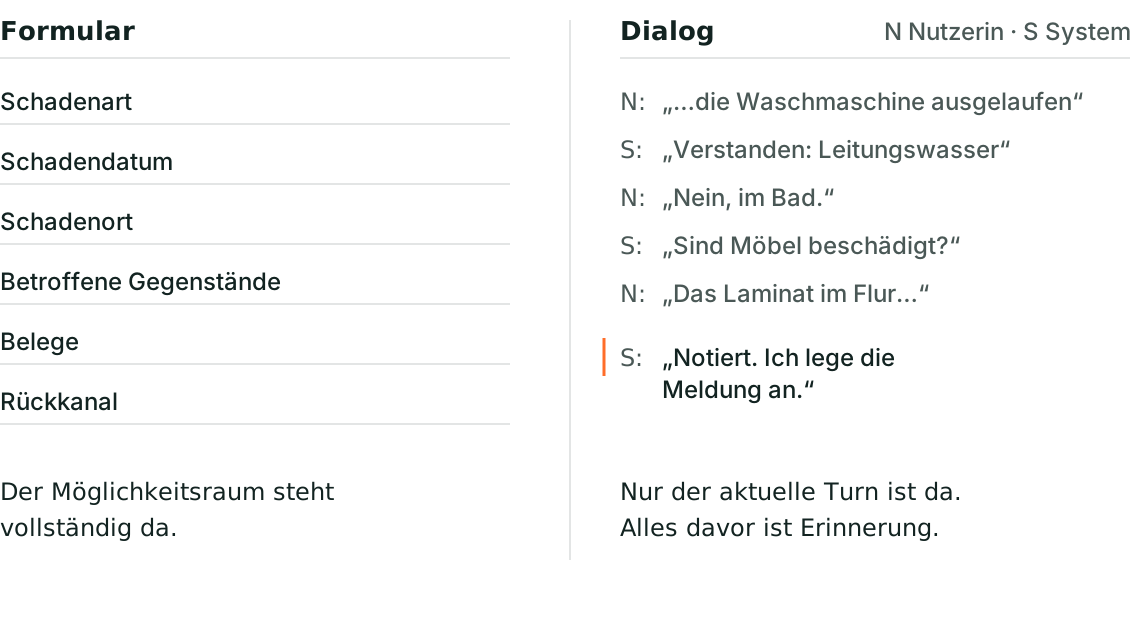
Es gibt eine UX-Heuristik, die jeder kennt: Recognition over Recall. Konversation verletzt sie systematisch.
| Sichtbares GUI | Leere Eingabezeile |
|---|---|
| Der Möglichkeitsraum ist sichtbar: Menüs, Buttons, Felder | Der Möglichkeitsraum ist unsichtbar |
| Recognition: Ich erkenne, was geht | Recall: Ich muss wissen oder raten, was geht |
| Fehler sind vorhersehbar | Fehler entstehen bei der ersten Äußerung |
Die Nutzerin muss wissen, was das System kann, bevor sie den ersten Satz schreibt. Ohne Onboarding, ohne Vorschläge, ohne Kontext rät sie. Das lässt sich abmildern, aber nicht abschaffen, weil es keine Implementierungsfrage ist, sondern eine Eigenschaft des Paradigmas.
Genau das ist die Lektion aus dem Voice- und Bot-Hype von 2016 bis 2018, und die halte ich für unterschätzt. Gartner sagte im Oktober 2016 voraus, dass bis 2020 dreißig Prozent aller Web-Browsing-Sessions ohne Bildschirm laufen würden. Ein halbes Jahr später berichtete The Information, dass Messenger-Bots nur rund dreißig Prozent der Anfragen ohne menschliches Eingreifen erledigten; Facebook verengte den Scope auf wenige Fälle, ausdrücklich damit Nutzer nicht von den Grenzen der Automatisierung enttäuscht würden. Bei Alexa standen rund hunderttausend Skills einer Nutzung gegenüber, die zu großen Teilen aus Timern, Musik und Wetter bestand. Amazons Gerätesparte schrieb zwischen 2017 und 2021 über 25 Milliarden Dollar Verlust.
Nicht die Technik hat versagt, sondern die Annahme, dass Konversation überall die überlegene Schnittstelle sei. Das ist kein Abgesang. Die Assistenten bekommen mit generativer KI gerade eine zweite Chance, und sie ist ernst zu nehmen. Nur die Frage, ob Konversation hier die richtige Modalität ist, bleibt exakt dieselbe.
Vier Kriterien für die Modalitätsentscheidung
Die praktische Konsequenz ist ein kleiner Satz von Prüffragen, den ich inzwischen an jeden Use Case anlege:
- Discoverability: Woher weiß die Nutzerin, was hier geht und was nicht?
- Struktur der Aufgabe: Wie viel davon ist Formular, wie viel ist Gespräch?
- Emotionale Lage: Was braucht jemand in dieser Situation? Nach einem Einbruch ist niemand in Formularlaune.
- Lenkungsbedarf: Wo muss das System Optionen sichtbar machen, damit die Nutzerin nicht rät, und wo darf es gerade nicht lenken?
Zwei Merksätze dazu, die im Seminar am meisten gearbeitet haben. Der erste: Nicht konversationalisieren, was ein Formular besser kann. Acht strukturierte Felder erledigt ein Formular in neunzig Sekunden, ein Chat braucht acht Turns dafür.
Der zweite betrifft die agentischen Systeme, über die derzeit alle reden: Ein Chat-Thread ist kein Workflow-Tracker. Ein Gespräch hat eine Gesprächskadenz: Turn für Turn, im Moment, flüchtig. Ein Vorgang hat eine Arbeitskadenz: über Tage, mit Zwischenständen, Rückfragen, Freigaben, Unterbrechungen. Wenn die Kundin heute drei Fotos hochlädt, morgen ein Dokument nachreicht und übermorgen nach dem Stand fragt: Wo sieht sie, was noch fehlt? Das ist eine GUI-Frage, und sie verschwindet nicht dadurch, dass das System agentisch wird.
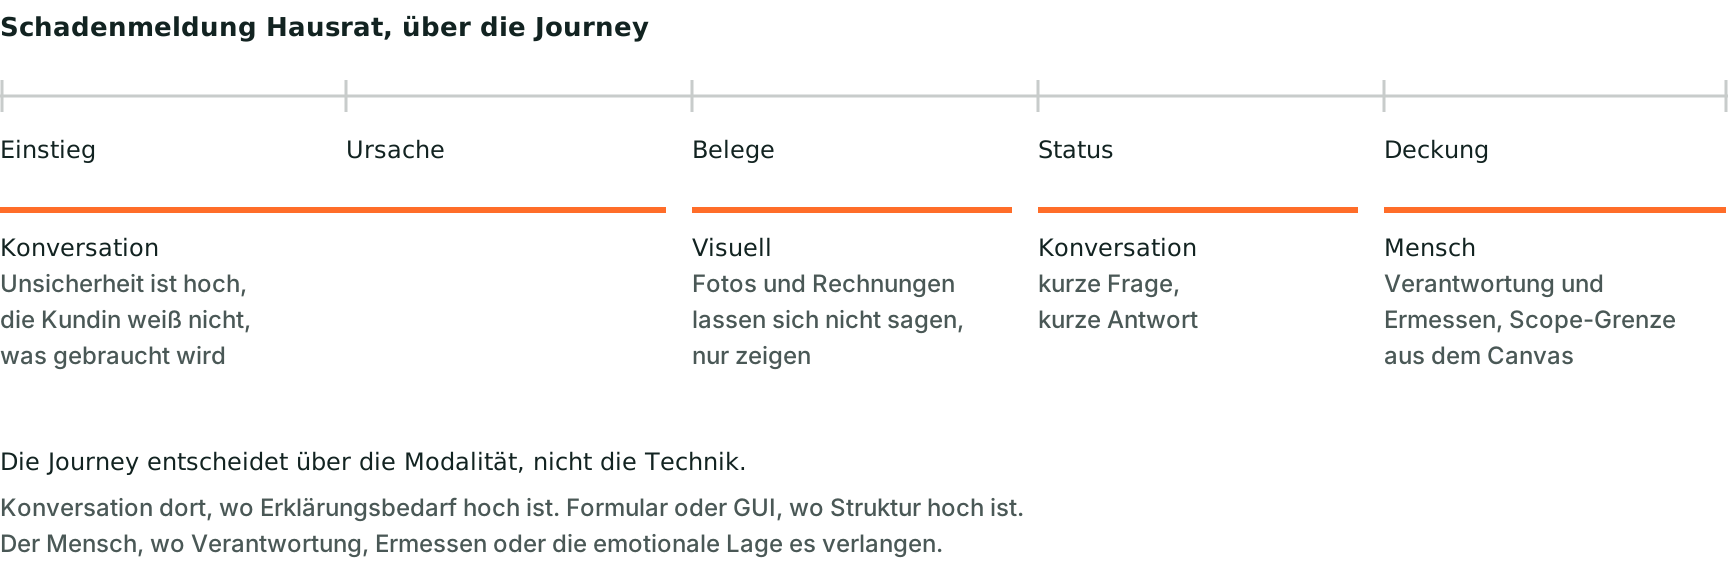
Die realistische Antwort ist in den allermeisten Fällen hybrid: Rich UI im Chat, also Buttons, Quick Replies, Datumswähler, Upload-Felder. Das ist keine Verlegenheitslösung, sondern die Produktionsrealität, und der einzige Weg, die Discoverability wenigstens teilweise zu lösen.
Was bleibt, was wandert
Die zweite große Verschiebung betrifft nicht die Frage, ob Konversation passt, sondern wo die Designarbeit stattfindet.
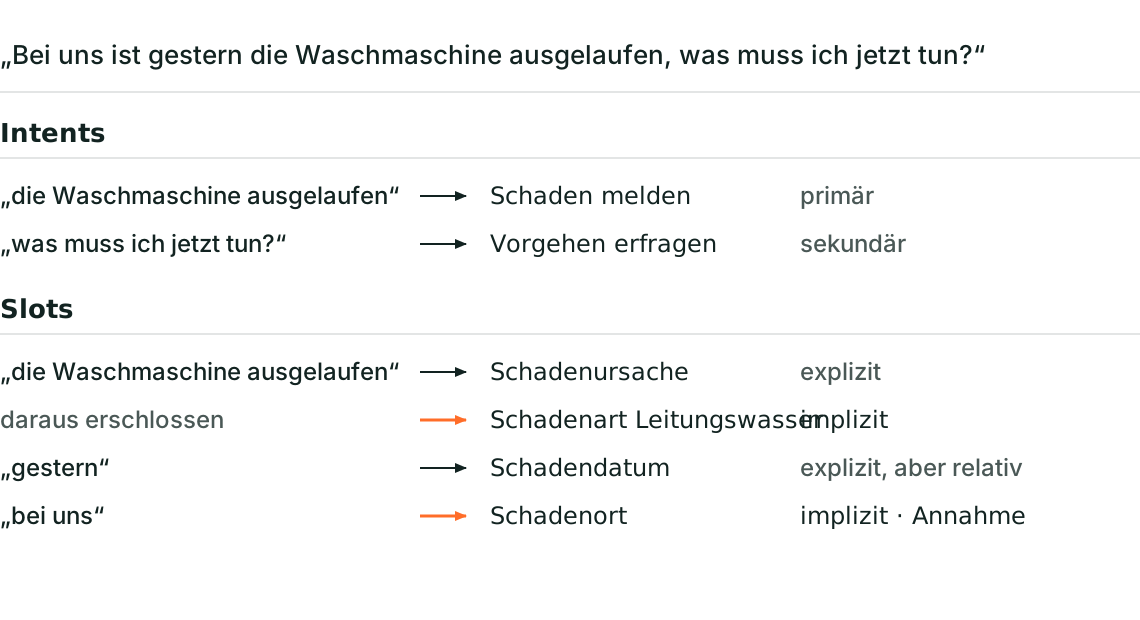
Das Denkmodell dahinter ist alt und technologieunabhängig: Intent ist die Absicht hinter der Äußerung, Utterance die konkrete Formulierung, Slot oder Entity der Parameter, den das System braucht. Slots sind das Datenmodell der Konversation, Intents die Use Cases, Utterances die Oberfläche. Der Unterschied zum Formular: Dort sind Slots als Felder sichtbar und die Reihenfolge ist fix. Im Gespräch kommen sie in beliebiger Reihenfolge, bündelweise, unvollständig oder gar nicht.
Ein Beispiel, an dem das sofort einleuchtet. Der Satz „Bei uns ist gestern die Waschmaschine ausgelaufen, was muss ich jetzt tun?“ enthält zwei Absichten und vier Slots, von denen zwei nur implizit da sind. „Bei uns“ heißt wahrscheinlich die versicherte Wohnung, aber das System weiß es nicht. „Gestern“ ist ein gültiger Wert, aber erst nach Auflösung gegen das aktuelle Datum, und die aufgelöste Angabe sollte bestätigt werden. Nach diesem alltäglich klingenden, scheinbar vollständigen Satz fehlen sechs von acht Pflichtangaben. Das ist der Normalfall, nicht die Ausnahme.
Was sich nun verschoben hat, ist nicht das Modell, sondern die Laufzeitgrenze:
| Was bleibt | Wohin es wandert |
|---|---|
| Was will die Nutzerin? | Früher: hand-authored Intents. Heute: Scope-Definition und Dialogführung |
| Welche Information fehlt noch? | Früher: Utterance-Sammlungen. Heute: Kontext-Kuratierung |
| Wie verzweigt der Dialog? | Früher: Entity-Training. Heute: Slot-Regeln und Prüfschritte zur Laufzeit |
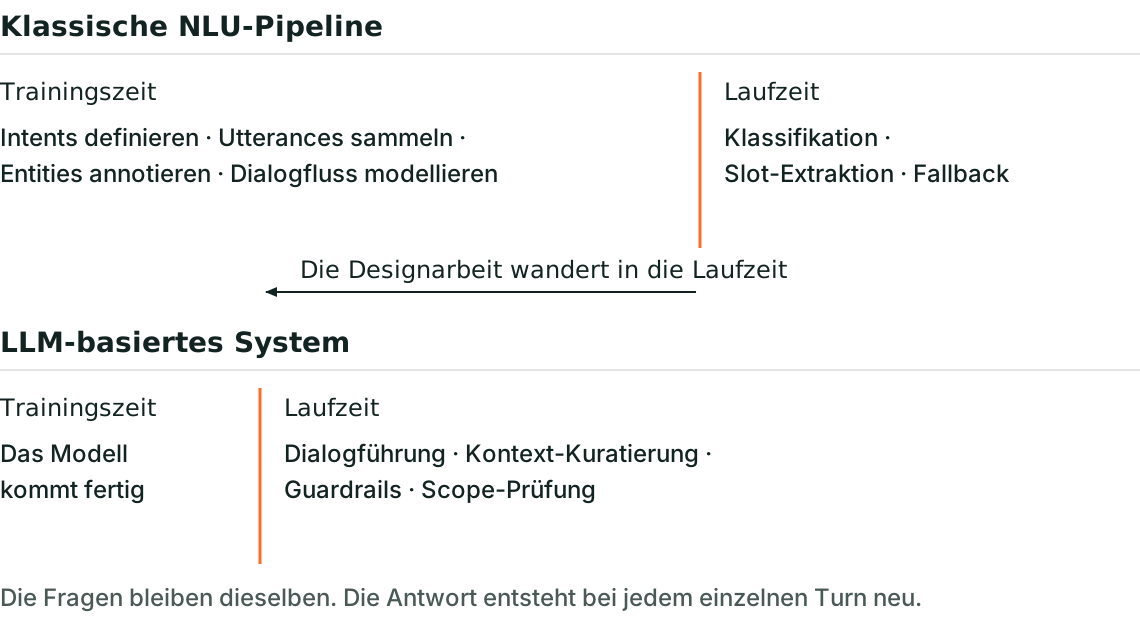
In der klassischen NLU-Pipeline steckte fast die gesamte Designarbeit vor dem Betrieb. Wer einen Intent vergaß, merkte es am Fallback. Dafür war das System deterministisch: Der Intent trifft oder trifft nicht, das Ergebnis ist vorhersagbar und prüfbar. Beim LLM kommt das Modell fertig, die Grenze rutscht weit nach links, und Dialogführung, Kontext-Kuratierung, Guardrails und Scope-Prüfung liegen in der Laufzeit. Das System schätzt, was gemeint ist, und kann sich plausibel irren.
Die Designarbeit verschwindet nicht. Sie wandert. Was früher in Intent-Listen und Utterance-Sammlungen stand, steht jetzt in Systemanweisungen, Kontextregeln, Prüfschritten und Übergabelogik. Und es wirkt bei jedem einzelnen Turn. Für UX ist das die gute Nachricht, weil es dieselben Fragen sind. Die weniger gute: Diese Fehler sind zur Laufzeit schwerer zu sehen als eine leere Utterance-Liste.
Deshalb ist die Frage „Braucht man im LLM-Zeitalter noch Intents?“ auch keine Ja-Nein-Frage. Sie ist falsch, wenn Intent das Denkmodell meint, und richtig, wenn Intent die hand-authored Trainingsliste meint. Beide Lager haben recht, sie reden über verschiedene Dinge.
Der Happy Path ist der Ausnahmefall
Wer einmal eine Conversation Map gezeichnet hat, mit Nutzer-Turns, System-Turns, Bedingungen, Slot-Status am Pfad und Abbrüchen, kennt den Effekt: Der Idealverlauf ist schnell fertig, und dann fängt die Arbeit an. In der Praxis stehen dort Tippfehler, halbe Antworten, Themenwechsel und Schweigen.
Die klassische Fehlerwelt ist überschaubar und verschwindet mit LLMs nicht, sie bekommt Gesellschaft: kein Treffer, keine Eingabe, Mehrdeutigkeit, außerhalb des Scopes, ungültiger Slot. Die Gegenmaßnahmen sind Handwerk. Die wichtigste ist die gezielte Rückfrage: nur nach der unklaren Stelle fragen, nicht nach allem. „Das habe ich nicht verstanden“ wirft sämtliche erfassten Angaben weg. Eine Rückfrage nach dem Datum lässt Schadenart und Ort stehen. Dazu kommen Eskalationsstufen, also nach dem zweiten Fehlschlag anders reagieren als nach dem ersten, und die Übergabe an einen Menschen mit Kontextmitnahme.
Interessanter ist die neue Fehlerwelt, und sie ist die, die Teams am wenigsten auf dem Schirm haben:
- Halluzination: eine plausible, aber falsche Auskunft. Die Kundin fragt „Ist das überhaupt versichert?“, und das System antwortet flüssig mit einer Deckungszusage, die es nicht geben darf.
- Multi-Turn-Drift: Das System verliert über mehrere Turns die Linie. Nach acht Turns Rückfragen zu Belegen ist die Schadenart vergessen, und die Zusammenfassung vor der Übergabe ist unvollständig. Die Arbeit Lost in Conversation (Laban et al., 2025) beschreibt genau das: In mehrstufigen, unterspezifizierten Gesprächen fallen Modelle gegenüber einer vollständigen Anfrage in einem einzigen Turn ab.
- Grounding-Verlust: System und Nutzerin meinen unterschiedliche Dinge, ohne es zu merken. „Nein, nicht die Küche, das andere Zimmer, und das war schon am Dienstag“ enthält Negation, Korrektur und Anapher in einem Satz. Wird die Korrektur nicht bestätigt, merkt es niemand: die Kundin nicht, weil sie es ja gesagt hat, und das System nicht, weil es plausibel weitermacht.
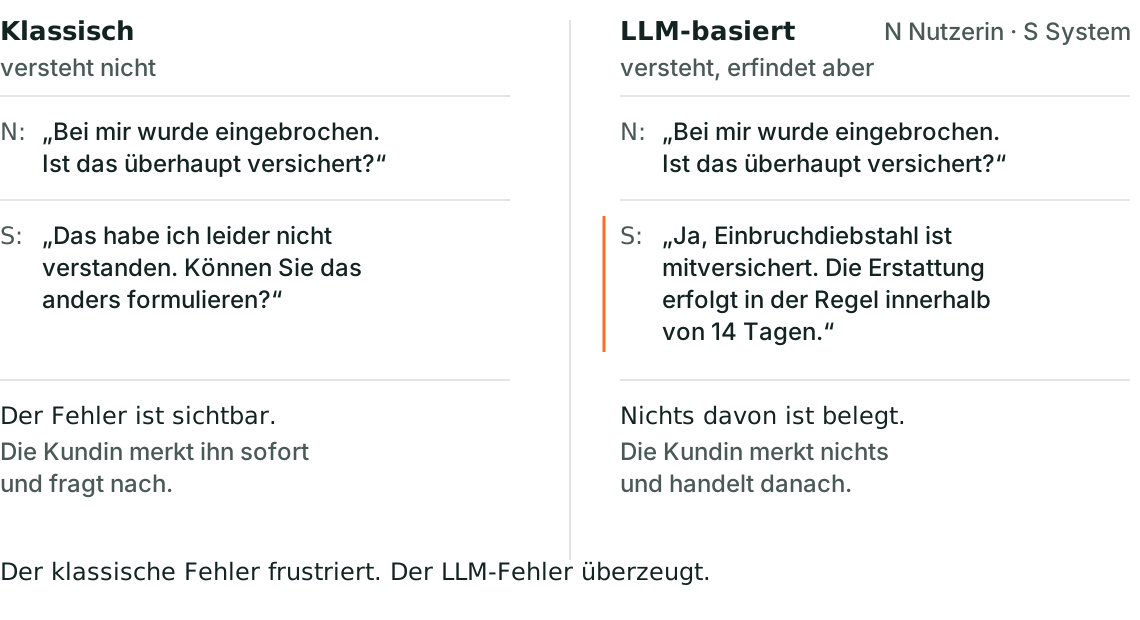
Der entscheidende Unterschied in einem Satz: Der klassische Fehler frustriert, der LLM-Fehler überzeugt. Ein frustrierter Mensch fragt nach. Ein überzeugter Mensch handelt nach der falschen Auskunft. Und im regulierten Umfeld ist eine erfundene Auskunft kein UX-Problem mehr, sondern ein Haftungsfall.
Die drei Gegenprinzipien, die dagegen helfen, wirken alle zur Laufzeit, und ich habe sie beim Bau eines echten Systems gelernt, nicht am Whiteboard: Weglassen statt ermahnen (was das Modell für diesen Turn nicht bekommt, kann es nicht falsch verwenden; eine Anweisung „erfinde nichts“ ist schwächer als ein Kontext, in dem nichts zu erfinden ist), Ähnlichkeit ist kein Wissen (dass eine Frage wie eine beantwortbare klingt, heißt nicht, dass die Antwort im System steht) und lieber nachfragen als raten (ein Gespräch mit einer Rückfrage zu viel ist reparierbar, eine falsche Zusage nicht). Wie das konkret aussieht, habe ich im Praxisbericht zum Bürger-Chatbot einer Kommune aufgeschrieben.
Guardrails sind Designarbeit, keine reine Technik. Das ist dieselbe Verschiebung wie oben, nur am konkreten Fehler.
Persona ist eine Governance-Frage
Ein Formular fragt ab. Ein Dialog verhandelt, bestätigt, reagiert. Wer angesprochen wird, erwartet ein Gegenüber, und diese Beziehungserwartung entsteht mit dem ersten Satz, ob gewollt oder nicht. Sie lässt sich nicht abschalten, nur gestalten. Die Frage ist also nie, ob wir eine Persona wollen. Sobald das System spricht, hat es eine. Die Frage ist, ob sie jemand bewusst entschieden hat.
Ich beschreibe sie in drei Ebenen, weil sich das sauber prüfen lässt:
| Ebene | Frage | Beispiele |
|---|---|---|
| Charakter | Wer spricht? | hilfsbereit, verlässlich, nüchtern, geduldig |
| Stimme | Wie klingt es? | sachlich, zugewandt, knapp; Satzlänge, Rhythmus, Wärme |
| Sprache | Welche Regeln gelten? | Anrede, Fachbegriffe, Emojis, Humor, Umgang mit Unsicherheit |
Der Charakter ist stabil, die Stimme wechselt mit der Situation, die Sprache ist prüfbar. Der beste Kniff bei den Charakter-Attributen ist der Gegenpol: „empathisch“ allein ist ein Blankoscheck, „zugewandt, aber nicht vertraulich“ ist eine Designentscheidung.
Der Grund, warum das mehr als Stil ist, liegt in drei Fehlbildern, die ein menschlich wirkender Assistent erzeugt. Empathie-Theater: Das System behauptet Gefühle, die es nicht hat, und das wirkt in belasteten Situationen hohl oder verletzend. Falsche Fähigkeitserwartung: Wer wie ein Sachbearbeiter klingt, dem traut man Zusagen zu. Vertrauen ohne Deckung: Tonalität schafft Vertrauen, das die Fähigkeiten des Systems nicht einlösen.
Eine Persona, die kompetent und souverän klingt, macht eine Halluzination gefährlicher, nicht harmloser.
Im Seminar arbeite ich das über eine Aufstellung im Raum heraus. Die These lautet: „Ein Versicherungsassistent sollte nach einem Einbruch Mitgefühl ausdrücken.“ Die Diskussion dazu könnte einen halben Tag fressen, deshalb wird sie nicht aufgelöst, sondern in die Teamarbeit verschoben, an den selbst geschriebenen Dialog. Dort fällt die Unterscheidung dann von allein: Mitgefühl ausdrücken heißt nicht Mitgefühl behaupten. „Das tut mir leid“ ist eine Gefühlsbehauptung. „Ich nehme das jetzt auf, damit Sie sich um anderes kümmern können“ ist Handlungsfähigkeit. Das ist die Form, in der ein System Anteilnahme zeigen kann, ohne zu lügen.
Die Übergaben sind der Prüfstein
Und hier liegt für mich der Kern der ganzen Sache. Die Kundin bewertet einen Assistenten an der Übergabe, nicht am Happy Path.
In den meisten Projekten wird der Dialog sorgfältig konzipiert und die Übergabe dem Backend überlassen. Dann heißt es „Ein Mitarbeiter meldet sich bei Ihnen“, und der Mitarbeiter fragt von vorn. Das ist kein Technikproblem, das ist ein Konzeptionsproblem.
Drei Arten von Übergabe kommen in fast jedem Service-Use-Case vor:
- Bot zu Mensch. Alle Slots und der Gesprächsverlauf gehen mit, der Mensch fragt nichts, was der Bot schon weiß, das System sagt, wann und wie sich jemand meldet, und die Tonalität bleibt dieselbe, nicht kälter, nicht wärmer.
- Voice zu Visuell. Die Nutzerin muss etwas zeigen, das sich nicht sagen lässt. Fotos, Rechnungen, Dokumente. Hier endet Voice als Modalität, und das ist kein Fehler, sondern die Grenze der Modalität. Der am häufigsten vergessene Teil ist der Rückkehrpunkt: Nach dem Upload muss das System wissen, dass die Belege da sind, und dort weitermachen, wo das Gespräch stand, nicht bei der Begrüßung.
- Chat zu App. Die leiseste der drei, weil sie oft gar nicht als Übergabe wahrgenommen wird. Die Kundin schließt mittags den Browser am Laptop und öffnet abends die App am Handy. Aus ihrer Sicht ist das derselbe Vorgang. Wer sich im Chat identifiziert hat, darf nicht ein zweites Mal gefragt werden.
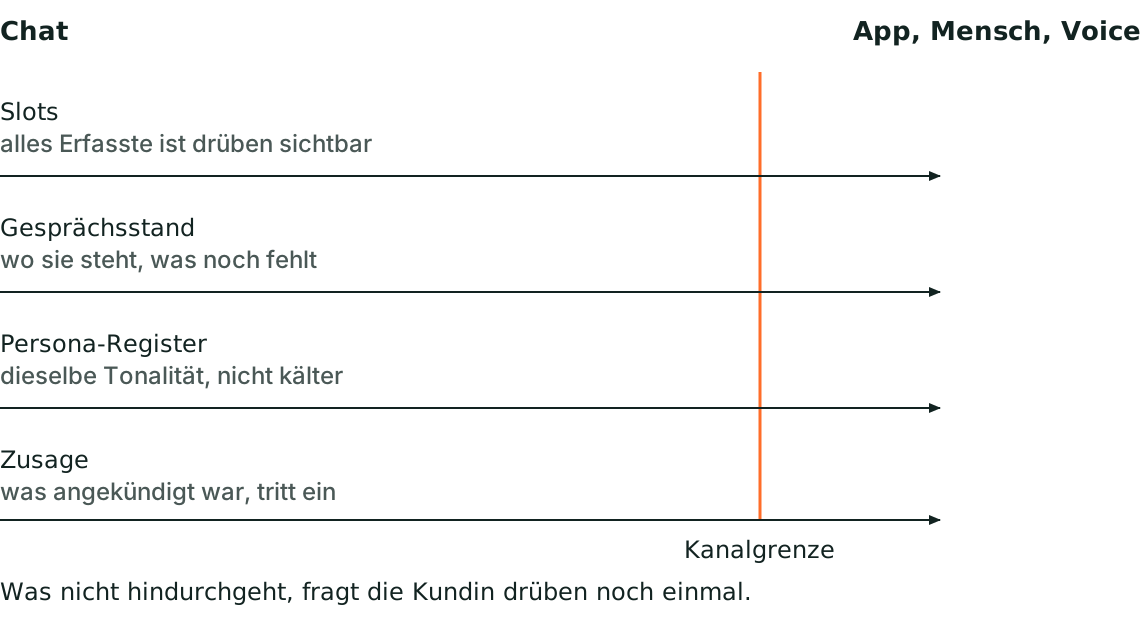
Vier Dinge müssen jede Kanalgrenze passieren: die erfassten Slots, der Gesprächsstand, das Persona-Register und die Zusage an die Kundin. Die ersten beiden sind die technische Seite. Die letzten beiden sind die Erlebnisseite, und daran scheitern Übergaben in der Praxis öfter: Der Bot war zugewandt, das Formular ist Behördendeutsch, der Rückruf kommt zwei Tage später als angekündigt.
Der letzte Punkt ist der, den ich am häufigsten unterschätzt sehe. Eine Zusage zur Wartezeit oder zum nächsten Schritt ist eine Zusage des Unternehmens. Der Assistent spricht nicht für sich, er spricht für die Organisation. Wenn er „innerhalb von 24 Stunden“ sagt, muss der Prozess das halten. Deshalb gehört die Übergabe in die Governance und nicht nur ins Wording.
Und weil die Frage kommt: Bei Bot-zu-Bot-Interaktion ändert sich daran nichts Grundsätzliches. Turn-Taking, Grounding, Reparatur und Scope-Grenze gelten weiter, sie werden nur maschinell verhandelt. Discoverability wird dann zur maschinenlesbaren Fähigkeitsbeschreibung: Der fremde Agent muss wissen, was unser Assistent kann und was nicht. Wer eine saubere Scope-Grenze formuliert hat, hat diese Beschreibung schon halb.
Und dann kommt jemand mit einer Zahl
„Unsere Containment Rate liegt bei 92 Prozent.“ Ist das ein gutes Ergebnis?
Die ehrliche Antwort lautet: nicht entscheidbar. Und das ist keine Ausflucht, sondern der wichtigste Satz zum Thema Messung.
Es gibt zwei Metrikfamilien, die nie vermischt werden dürfen. Betriebsmetriken kommen aus Logs und beschreiben, was das System getan hat: Containment Rate, Fallback Rate, Task Completion, Handover Rate, Abbruchquote, Turns pro Aufgabe. Erlebnismetriken kommen aus Befragungen und beschreiben, wie die Kundin es erlebt hat: CSAT, der Chatbot Usability Questionnaire (Holmes et al., 2019) und der User Experience Questionnaire. Betriebsmetriken sind billig, automatisch und lückenlos. Erlebnismetriken sind teuer, freiwillig und lückenhaft. Deshalb dominieren die Betriebsmetriken jeden Report, und deshalb entstehen die Fehlschlüsse: Man liest aus Logs heraus, was nur eine Befragung beantworten könnte. Wer aus dem UX Research den Unterschied zwischen Verhaltensdaten und Selbstauskunft kennt, kennt genau diese Trennung, nur unter anderem Namen.
Vier Fallstricke sehe ich immer wieder:
1. Der perverse Anreiz der Containment Rate. Sie misst den Anteil der Gespräche ohne Übergabe an einen Menschen. Sie misst nicht, ob das Anliegen gelöst wurde. Der einfachste Weg zu einem hohen Wert ist deshalb, die Übergabe zu erschweren. Der Anreiz entsteht nicht im Designteam, sondern in der Zielvereinbarung: Wenn die Containment Rate im OKR steht, wird sie optimiert. Die vermiedenen Kontakte tauchen im Servicecenter wieder auf, nur später und verärgerter.
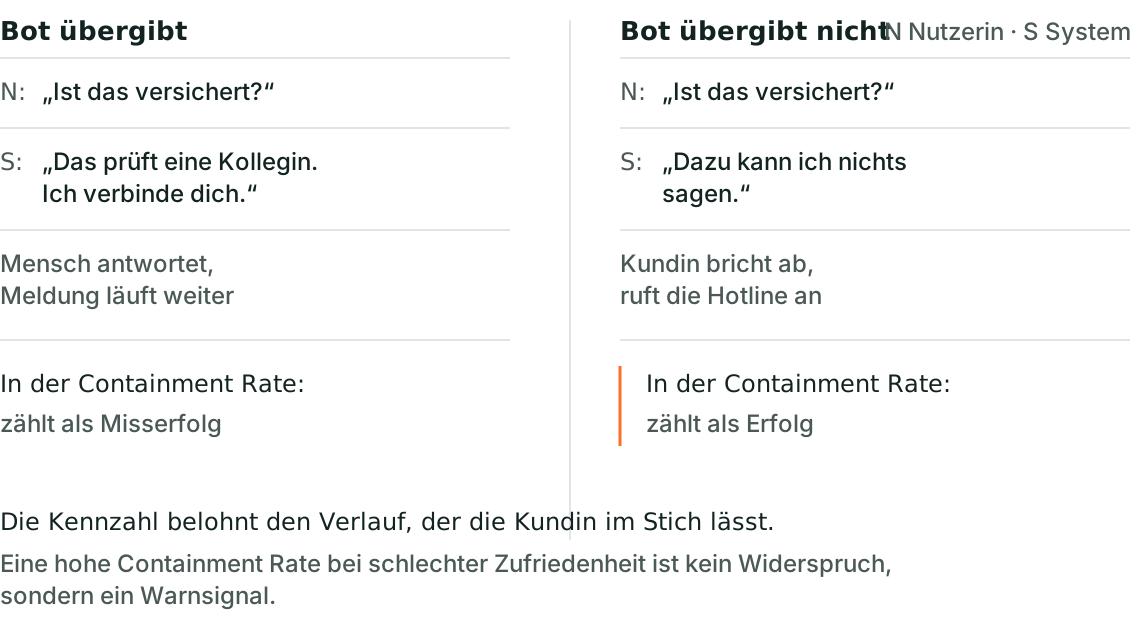
2. Wer definiert „Aufgabe erledigt“? Task Completion ist nur so gut wie ihre Zieldefinition, und die ist eine Designentscheidung, keine technische Gegebenheit. Der häufigste Fehler: Die Übergabe an einen Menschen zählt als Misserfolg. Damit bestraft man genau das Design, das man haben will.
3. Fallback sieht keine Halluzination. Ein Fallback wird ausgelöst, wenn das System merkt, dass es nicht weiterweiß. Eine erfundene Antwort ist flüssig, plausibel und löst keinen Fallback aus. Eine niedrige Fallback Rate heißt: Das System hat selten gezweifelt. Nicht: Es hatte selten Unrecht.
4. „Optimierung“ als Warnsignal. Containment steigt, Handover sinkt, über drei Monate, nach einem Release. Das sieht aus wie Erfolg. Die Frage ist: Was wurde optimiert, das Verstehen oder die Übergabeschwelle? Zwei Prüfungen helfen: die Release Notes lesen und die Abbruchquote im selben Zeitraum ansehen. Wenn Übergaben sinken und Abbrüche steigen, wurde die Kundin nicht besser bedient, sondern länger festgehalten.
Zurück zu den 92 Prozent. Ohne Erlebnismetrik ist unbekannt, ob die Kundin bekommen hat, was sie wollte. Ohne Zieldefinition ist unbekannt, ob „nicht übergeben“ hier überhaupt Erfolg bedeutet. Ohne Halluzinationsprüfung ist unbekannt, ob in den 92 Prozent richtige Antworten stecken. Ohne Trend und Release-Historie ist unbekannt, wie die Zahl zustande kam.
Eine hohe Containment Rate bei schlechter Zufriedenheit ist kein Widerspruch, sondern ein Warnsignal. Und eine Betriebsmetrik allein beantwortet keine Qualitätsfrage. Sie liefert eine Auffälligkeit. Die Qualitätsfrage beantwortet man mit einer Hypothese und einer Prüfung, und zwar in dieser Reihenfolge: Der Sprung von der Auffälligkeit direkt zur Maßnahme ist befriedigend und trifft zuverlässig die falsche Ursache.
Was deterministisch bleiben muss
Das führt am Ende zu einer Architekturfrage, die in Wahrheit eine Designfrage ist. Sie lautet nicht „Flow oder LLM?“, sondern: Welcher Schritt braucht welche Verlässlichkeit?
| Deterministisch | Probabilistisch |
|---|---|
| Identifikation der Kundin | Verstehen freier Äußerungen, Intent und Slots zur Laufzeit |
| Pflichtangaben mit Validierung | Erklären, was als Nächstes passiert und warum |
| Jede Zusage an die Kundin (Frist, Rückruf, nächster Schritt) | Formulieren in der Persona, Registerwechsel |
| Übergabe an einen Menschen, Ausfallrichtung | Umgang mit Unerwartetem innerhalb der Scope-Grenze |
| Alles Haftungsrelevante | Alles, was sich plausibel irren darf |
Faustregel im regulierten Umfeld: Was das Unternehmen bindet, bleibt deterministisch.
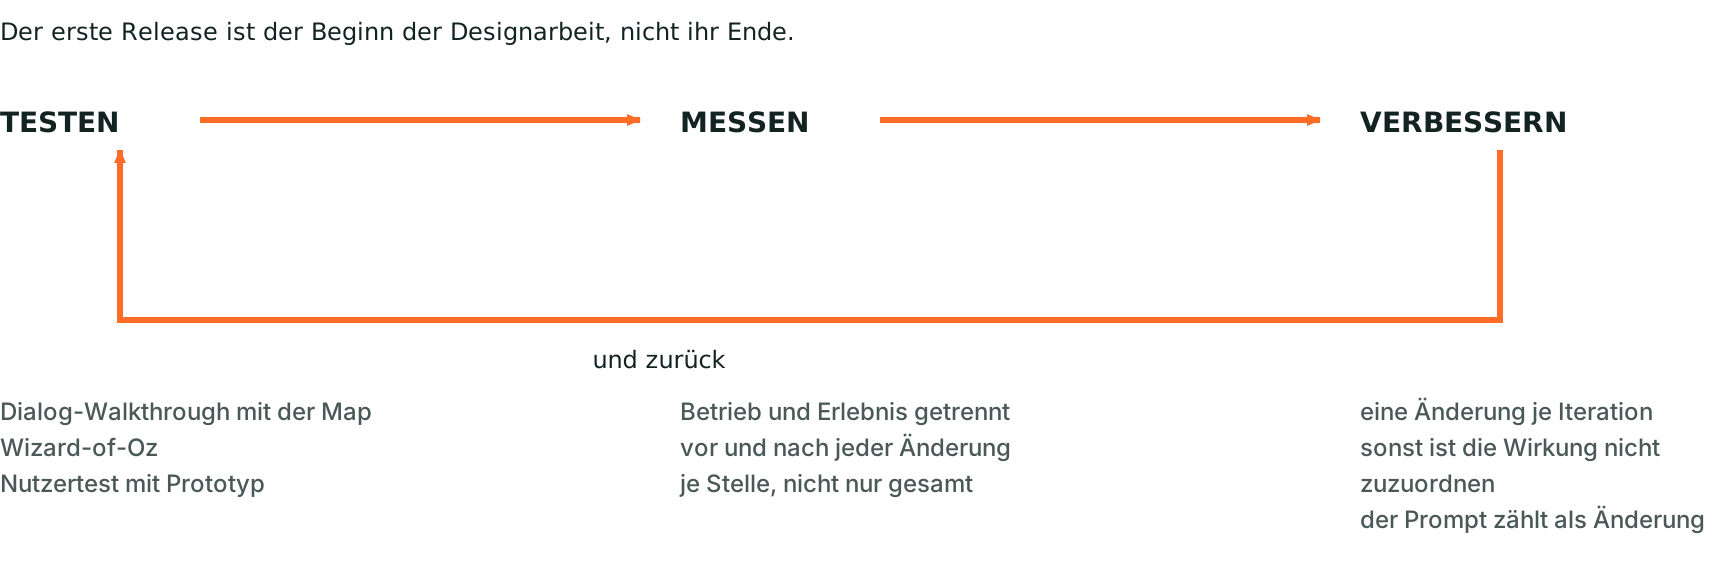
Der Ort, an dem diese Entscheidungen zusammenlaufen, ist der System-Prompt. Und der ist damit ein Designartefakt, kein Konfigurationsdetail: Rolle und Transparenz, Aufgabe und Scope, Sprachregeln aus dem Persona-Steckbrief, Kontextregeln, Ausfallrichtung. Wer den Prompt schreibt, gestaltet den Dialog. Das gehört zu UX und nicht allein zur Entwicklung, mit allem, was daran hängt: versionieren, gegen einen festen Satz Testdialoge prüfen, eine Änderung je Iteration, Wirkung an der betroffenen Stelle messen. Dass ich viel mit Coding-Agenten arbeite, macht diesen Punkt nicht kleiner, sondern größer: Je schneller gebaut wird, desto mehr hängt an der Frage, ob jemand das Ergebnis beurteilen kann.
Die eigentliche Lektion
Eine Conversation Map ist nicht das Artefakt aus der Zeit vor den Sprachmodellen. Sie ist das Gerüst, das dem Modell sagt, wo es steht. Sie ist nicht überflüssig geworden, sie ist wichtiger geworden, weil sie das ist, was das Team zur Laufzeit noch kontrolliert.
Und die Frage, mit der ein Projekt anfängt, ist nicht „Wie bauen wir einen guten Chatbot?“. Sie ist: Wo gehört Konversation in unsere Kanal- und Servicestrategie, und wo hört sie auf? Konversation ist eine Modalität unter mehreren. Die Übergaben sind der Prüfstein, nicht der Happy Path.
Ein guter Assistent ist einer, der weiß, wann er abgibt. Und der erste Release ist der Beginn der Designarbeit, nicht ihr Ende.
Literatur
Clark, H. H. (1996). Using language. Cambridge University Press. https://doi.org/10.1017/CBO9780511620539
Grice, H. P. (1975). Logic and conversation. In P. Cole & J. L. Morgan (Hrsg.), Syntax and semantics 3: Speech acts (S. 41–58). Academic Press.
Holmes, W., Moorhead, A., Bond, R., Zheng, H., Coates, V., & McTear, M. (2019). Usability testing of a healthcare chatbot: Can we use conventional methods to assess conversational user interfaces? In Proceedings of the 31st European Conference on Cognitive Ergonomics (S. 207–214). ACM. https://doi.org/10.1145/3335082.3335094
Laugwitz, B., Held, T., & Schrepp, M. (2008). Construction and evaluation of a user experience questionnaire. In A. Holzinger (Hrsg.), HCI and Usability for Education and Work (LNCS Bd. 5298, S. 63–76). Springer. https://doi.org/10.1007/978-3-540-89350-9_6
Sacks, H., Schegloff, E. A., & Jefferson, G. (1974). A simplest systematics for the organization of turn-taking for conversation. Language, 50(4), 696–735. https://doi.org/10.2307/412243
Häufige Fragen
Der Begriff hat zwei Lesarten, und die meisten Missverständnisse entstehen, weil sie vermischt werden. Als Medium meint Conversational Design die Gestaltung für Chat- und Voice-Kanäle: Messenger, Website-Chat, Sprachassistent, Telefonbot. Die Frage lautet dann: Wie gestalten wir gut für diesen Kanal? Als Designphilosophie meint es, die Prinzipien menschlicher Konversation als Interaktionsmodell zu nehmen: Turn-Taking, geteilter Kontext, Reparatur. Die Frage lautet dann: Was können wir von Gesprächen für jede Schnittstelle lernen? Beide Lesarten sind legitim. Wer sie nicht auseinanderhält, diskutiert aneinander vorbei.
Immer dann, wenn ein Formular die Aufgabe besser erledigt. Acht strukturierte Felder fragt ein Formular in neunzig Sekunden ab, ein Chat braucht dafür acht Turns. Dazu kommt die strukturelle Schwäche der Konversation: Eine leere Eingabezeile zeigt nicht, was das System kann. Die Nutzerin muss wissen oder raten, statt zu erkennen. Das lässt sich durch Vorschläge und Quick Replies abmildern, aber nicht abschaffen, weil es eine Eigenschaft des Paradigmas ist und kein Implementierungsfehler. Und ein Chatverlauf taugt nicht als Workflow-Tracker: Ein Vorgang, der sich über Tage zieht, braucht einen Ort, an dem der Stand sichtbar ist.
Das kommt darauf an, was mit Intent gemeint ist. Als Denkmodell ist der Begriff unverzichtbar: Ohne eine Vorstellung davon, was die Person erreichen will, weiß niemand, wofür das System zuständig ist und wann ein Gespräch fertig ist. Als hand-authored Trainingsartefakt, also als Liste von Intents mit Hunderten gesammelten Beispieläußerungen, ist er in den meisten neuen Projekten Legacy. Die Designarbeit verschwindet dabei nicht, sie wandert: von der Trainingszeit in die Laufzeit, also in Dialogführung, Kontext-Kuratierung, Guardrails und Scope-Prüfung.
Der klassische Fehler frustriert, der LLM-Fehler überzeugt. Ein regelbasiertes System, das eine Äußerung nicht zuordnen kann, sagt das: kein Treffer, Fallback, „Das habe ich nicht verstanden.“ Der Fehler ist sichtbar, und ein frustrierter Mensch fragt nach. Ein LLM-System antwortet flüssig, freundlich und im Zweifel falsch. Ein überzeugter Mensch handelt nach der falschen Auskunft. Die drei wichtigsten Fehlerklassen sind Halluzination (eine plausible, aber falsche Auskunft), Multi-Turn-Drift (das System verliert über mehrere Turns die Linie) und Grounding-Verlust (System und Nutzerin meinen unterschiedliche Dinge, ohne es zu merken). Im regulierten Umfeld ist eine erfundene Auskunft kein UX-Problem, sondern ein Haftungsfall.
Die Containment Rate misst den Anteil der Gespräche, die ohne Übergabe an einen Menschen enden. Sie misst nicht, ob das Anliegen gelöst wurde und ob die Antworten richtig waren. Der einfachste Weg zu einer hohen Containment Rate ist deshalb, die Übergabe zu erschweren. Wer eine gestaltete Übergabe als Misserfolg zählt, bestraft gutes Design, und die vermiedenen Kontakte tauchen später im Servicecenter wieder auf, nur verärgerter. Eine hohe Containment Rate bei schlechter Zufriedenheit ist kein Widerspruch, sondern ein Warnsignal. Ohne Erlebnismetrik, ohne schriftliche Zieldefinition und ohne Halluzinationsprüfung lässt sich aus der Zahl allein nichts über Qualität sagen.
Weil sie nicht abgeschaltet werden kann. Sobald ein System spricht, hat es eine Persona; die einzige Frage ist, ob sie bewusst entschieden wurde. Ein menschlich wirkender Assistent erzeugt drei Fehlbilder: Empathie-Theater (das System behauptet Gefühle, die es nicht hat), falsche Fähigkeitserwartung (wer wie ein Sachbearbeiter klingt, dem traut man Zusagen zu) und Vertrauen ohne Deckung. Eine überzeugende Stimme macht eine erfundene Auskunft glaubwürdiger, nicht harmloser. Deshalb sind Charakter, Register und Sprachregeln Entscheidungen, die jemand verantworten, prüfen und freigeben muss, so wie einen Styleguide.
Vier Dinge: die erfassten Slots, der Gesprächsstand, das Persona-Register und die Zusage an die Kundin. Die ersten beiden sind die technische Seite, die letzten beiden die Erlebnisseite, und an der scheitern Übergaben in der Praxis öfter. Der Bot war zugewandt, das Formular ist Behördendeutsch, der angekündigte Rückruf kommt zwei Tage später als versprochen. Eine Übergabe ist immer auch eine Zusage: Wenn das System „innerhalb von 24 Stunden“ sagt, muss der Prozess das halten. Deshalb gehört die Übergabe in die Governance und nicht nur ins Wording.